8. Koodin tehokkuus
Koodin tehokkuuteen vaikuttavat koodin toimintalogiikka, koodin toteutuksen yksityiskohdat sekä tietokoneen prosessorin toiminta koodia suorittaessa.
Koodin toimintalogiikka tarkoittaa koodin korkean tason ideaa, kuten mitä algoritmeja ja tietorakenteita koodi käyttää. Tällä tasolla tehokkuutta arvioidaan usein aikavaativuuden avulla. Esimerkiksi O(n log n)-aikainen algoritmi toimii yleensä nopeammin kuin O(n2)-aikainen algoritmi. Aikavaativuus on hyvä työkalu koodin tehokkuuden arviointiin, mutta se ei kerro kaikkea tehokkuudesta.
Tällä kurssilla kiinnitämme enemmän huomiota koodin matalan tason tehokkuuteen: miten haluttu toimintalogiikka toteutetaan tehokkaasti ja miten prosessori pystyy suorittamaan koodin tehokkaasti. Tällaisilla asioilla voi olla suuri vaikutus koodin tehokkuuteen. Saman algoritmin eri toteutusten suoritusajoissa voi olla kymmen- tai satakertainen tehokkuusero.
Tehokkuuden yleiskuva
Kääntäjän toiminta
Suuri vaikutus koodin tehokkuuteen on kääntäjällä, joka kääntää C-kielisen koodin konekielelle tietokoneen prosessorin suoritettavaksi. Kääntäjän tehtävänä on saada aikaan konekielinen koodi, jonka toiminta vastaa alkuperäistä koodia ja joka lisäksi toimii tehokkaasti.
Tarkastellaan esimerkkinä seuraavaa C-kielistä koodia:
int result;
if (phase > 5) {
    result = 1;
} else {
    result = 2;
}
Kääntäjä voisi kääntää koodin seuraavasti x86-konekielelle:
    mov eax, [rbp-16]
    cmp eax, 5
    jle .L2
    mov dword [rbp-12], 1
    jmp .L3
.L2:
    mov dword [rbp-12], 2
.L3:
Tämä koodi muodostuu seuraavista konekielen komennoista:
mov eax, [rbp-16]kopioi luvun pinosta kohdasta-16rekisteriineax.cmp eax, 5vertailee rekisterineaxsisältöä ja lukua5.jle .L2hyppää kohtaan.L2, joseax <= 5.mov dword [rbp-12], 1asettaa pinoon kohtaan-12luvun1.jmp .L3hyppää kohtaan.L3.mov dword [rbp-12], 2asettaa pinoon kohtaan-12luvun2.
Kääntäjä tuottaa suoritettavan ohjelmatiedoston, joka sisältää konekielisen koodin tietokoneen prosessorin ymmärtämässä tavumuodossa. Esimerkiksi äskeinen konekielinen koodi näyttää seuraavalta tavumuodossa:
8b 45 f0 83 f8 05 7e 09 c7 45 f4 01 00 00 00 eb 07 c7 45 f4 02 00 00 00
Tässä jokaista konekielistä komentoa vastaa tietty tavuyhdistelmä, jonka prosessori osaa käsitellä halutulla tavalla. Esimerkiksi tavuyhdistelmä 8b 45 f0 vastaa komentoa mov eax, [rbp-16]. Konekielisen koodin käsittely tavumuodossa on ihmiselle vaikeaa, eikä sille ole yleensä tarvetta.
Tutustumme tarkemmin konekielen toimintaan materiaalin seuraavissa luvuissa. Tässä luvussa on joitakin konekielisiä koodiesimerkkejä, mutta ei haittaa, vaikka et ymmärtäisi vielä niiden toimintaa kaikilta osin.
Optimointiliput
Kääntäjän toimintaan vaikuttaa paljon, miten sitä on ohjeistettu optimoimaan koodia. Esimerkiksi gcc-kääntäjälle voidaan antaa erilaisia optimointilippuja, kuten:
| Optimointilippu | Selitys |
|---|---|
-O0 (oletus) |
Ei optimointia, suoraviivainen käännös |
-O1 |
Perustason optimoinnit |
-O2 |
Tason -O1 optimoinnit ja lisäoptimointeja |
-O3 |
Tason -O2 optimoinnit ja lisäoptimointeja |
-Os |
Binääritiedoston koon optimointi |
Tarkkaa tietoa optimointilippujen vaikutuksesta on kääntäjän dokumentaatiossa.
Koodin optimoinnin ilmeinen hyöty on, että se tehostaa käännetyn koodin suoritusta. Toisaalta optimointi hidastaa käännöstä, koska kääntäjällä menee aikaa koodin tehostamisen suunnittelemiseen.
Tavallinen tapa on käyttää käännöksessä optimointilippua -O2, joka tuottaa yleensä hyvän tuloksen. Jos koodin tehokkuus on hyvin tärkeää, lisäoptimoinnit kuten -O3 voivat auttaa joissain tilanteissa.
Ohjelmointikieli ja tehokkuus
C-kieli on tehokas ohjelmointikieli, mutta mitä tarkoittaa, että jokin ohjelmointikieli on tai ei ole tehokas? Oikeastaan on tarkempaa sanoa, että on olemassa kääntäjiä, jotka pystyvät kääntämään C-kielisestä koodista tehokasta konekielistä koodia eri prosessoreja varten. C-kieli ei olisi tehokas, jos näitä kääntäjiä ei olisi olemassa.
Toisaalta C-kielen tehokkuuteen vaikuttaa, että kieli on suunniteltu matalan tason ohjelmointiin sopivaksi. Esimerkiksi koodin käännösvaiheessa tiedetään määritellyt muuttujat ja niiden tietotyypit, perustietotyypit ovat lähellä konekieltä ja koodin suorituksen aikana ei tehdä tiettyjä muistin käsittelyyn liittyviä tarkastuksia.
Tarkastellaan esimerkkinä C-kielistä koodia total += items[i], jossa muuttuja total ja taulukko items ovat long-tyyppisiä. Koodi voitaisiin kääntää x86-konekieleksi esimerkiksi seuraavasti:
    mov rax, [items+8*rcx]
    add [total], rax
Tässä komento mov siirtää 64-bittisen luvun muistista rekisteriin rax ja komento add kasvattaa muistissa olevaa 64-bittistä lukua rekisterin rax arvolla. Nimet total ja items vastaavat muistiosoitteita, joihin muuttuja ja taulukko on tallennettu. Rekisteri rcx vastaa taulukon indeksiä i ja 8 on taulukon alkion koko tavuina.
Tämä konekielinen koodi toimii tehokkaasti, koska x86-konekielessä on tehokkaat komennot 64-bittisten kokonaislukujen käsittelyyn. Lisäksi koodin toimintaa tehostaa, että koodi olettaa rekisterin rcx osoittaman kohdan muistissa kuuluvan taulukon muistialueelle eikä tätä tarkasteta erikseen.
Vastaavan Python-koodin total += items[i] suorittaminen on selvästi hankalampaa tietokoneen prosessorin näkökulmasta. Koodia suorittaessa tulee ottaa huomioon esimerkiksi seuraavat asiat:
-
Pythonissa lukujen suuruutta ei ole rajattu, joten lukujen ei voi olettaa olevan esimerkiksi 64-bittisiä eikä niitä voi käsitellä suoraan tehokkaasti konekielessä.
-
Ennen koodin suorittamista ei tiedetä välttämättä, onko muuttujia
total,itemsjaimääritelty tai mitkä niiden tyypit ovat. -
Koodia suorittaessa tulee varmistaa, että muuttujalla
ivoi indeksoida oliotaitemsja indeksi on kelvollinen.
Python-koodia ei käännetä konekieliseksi koodiksi, jonka tietokoneen prosessori voisi suorittaa. Sen sijaan koodi käännetään tavukoodiksi, joka voidaan suorittaa Pythonin suoritusympäristössä. Tämä hidastaa koodia, koska käännetty koodi ei ole suoraan tietokoneen prosessorin suoritettavissa.
Miksi ei voisi tehdä kääntäjää, joka kääntää Python-koodin suoraan tehokkaaksi konekieleksi? Käytännössä tällaisen kääntäjän tekeminen olisi hyvin vaikeaa kielen ominaisuuksien takia. Esimerkiksi:
if random.randint(1, 2) == 1:
    a = 42
    b = 1337
else:
    a = "ayba"
    b = "btu"

c = a + b
Koodi asettaa satunnaisesti muuttujien a ja b arvoksi joko kokonaisluvut tai merkkijonot. Tämän jälkeen koodissa on rivi c = a + b, joka on joko lukujen yhteenlasku tai merkkijonojen yhdistäminen.
Miten rivi c = a + b tulisi kääntää konekieleksi? Ennen koodin suoritusta ei tiedetä, ovatko a ja b kokonaislukuja vai merkkijonoja, joten riville c = a + b ei ole yhtä konekielistä vastinetta, vaan tulee ottaa huomioon eri tilanteita.
Mikä ei vaikuta tehokkuuteen?
Koodin tehokkuuden kannalta on myös hyvä tiedostaa, mitkä asiat eivät vaikuta tehokkuuteen. Näitä ovat erilaiset koodin kirjoitusasuun liittyvät yksityiskohdat, jotka eivät välity prosessorin suorittamaan konekieliseen koodiin.
Esimerkiksi C-kielisen koodin toimintaa ei nopeuta, että pitkä muuttujan nimi item_count korvataan lyhyellä nimellä x. Kun kääntäjä kääntää koodin, se ei sisällytä ohjelmoijan käyttämiä muuttujien nimiä konekieliseen koodiin. Konekielessä tietoon ei viitata muuttujien nimillä vaan rekisterien ja muistiosoitteiden kautta.
Asiaa voi ajatella myös siltä kannalta, että jos jokin muutos koodissa saattaisi vaikuttaa tehokkuuteen mutta kääntäjä voisi helposti tehdä tämän muutoksen, niin muutoksella ei ole luultavasti todellista vaikutusta.
Esimerkiksi jos muuttujan nimen lyhentäminen tehostaisi koodia, kääntäjä voisi helposti korvata kaikki pitkät muuttujien nimet lyhyillä.
Tyhjä tila ja kommentit koodissa eivät vaikuta tehokkuuteen, koska ne eivät ole merkityksellisiä koodin tulkinnan kannalta. Esimerkiksi koodi if(x==42) ei ole tehokkaampi kuin koodi if (x == 42). Kääntäjän kannalta molemmat koodit voidaan esittää listana [if, (, x, ==, 42, )].
Koodin tehokkuuteen eivät myöskään vaikuta koodissa käytetyt lyhennysmerkinnät. Esimerkiksi lausekkeet ++a, a += 1 ja a = a + 1 ovat yhtä tehokkaita, koska nämä lausekkeet tarkoittavat samaa. Kääntäjän ei olisi järkevää tuottaa erilaista konekielistä koodia riippuen siitä, mitä näistä lausekkeista ohjelmoija on käyttänyt.
Tehokkuuden mittaus
Linux-ympäristössä kätevä tapa mitata koodin tehokkuutta on suorittaa ohjelma komennon time avulla. Mitataan esimerkkinä, kuinka tehokkaasti toimii seuraavasti koodi, joka laskee alkulukujen määrän välillä 1…107.
#include <stdio.h>

#define N 10000000

int sieve[N+1];

int main(void) {
    int count = 0;
    for (int i = 2; i <= N; i++) {
        if (!sieve[i]) count++;
        for (int j = 2*i; j <= N; j += i) {
            sieve[j] = 1;
        }
    }
    printf("%d\n", count);
}
Seuraava komento suorittaa mittauksen:
$ time ./test
664579

real	0m1.434s
user	0m1.403s
sys	0m0.031s
Tämä tarkoittaa, että koodin suoritus vei aikaa noin 1.4 sekuntia.
Mitä mitataan?
Koodin tehokkuuden mittaamisessa on oleellista, että mitattava koodi tekee varmasti sen asian, jonka tehokkuutta on tarkoitus mitata. Tämä ei ole niin helppoa kuin voisi ajatella, koska kääntäjän tekemät koodin optimoinnit saattavat muuttaa koodin toimintaa ja vääristää mittauksen tuloksia.
Tarkastellaan esimerkkinä seuraavaa koodia, joka laskee positiivisten kokonaislukujen summan miljardiin asti:
int main(void) {
    int n = 1000000000;
    long sum = 0;
    for (int i = 1; i <= n; i++) {
        sum += i;
    }
}
Koodi toimii yllättäen hyvin nopeasti, vaikka siinä on silmukka, jossa on miljardi askelta. Syynä nopeuteen on kuitenkin, ettei käännetyssä koodissa ole silmukkaa eikä mitään muutakaan. Koska muuttujan sum arvoa ei käytetä mihinkään, kääntäjä optimoi nokkelasti pois koko koodin ja tuottaa tyhjän ohjelman.
Asian voi korjata tulostamalla koodin päätteeksi muuttujan sum arvon:
int main(void) {
    int n = 1000000000;
    long sum = 0;
    for (int i = 1; i <= n; i++) {
        sum += i;
    }
    printf("%ld\n", sum);
}
Tämäkin koodi toimii epäilyttävän nopeasti, vaikka se tulostaa lukujen summan halutulla tavalla. Tässä tapauksessa koodi laskee summan aina samaan kiinteään lukuun asti, minkä takia summaa ei tarvitse laskea aina uudestaan koodin suorituksen aikana. Kääntäjä on poistanut koodista silmukan ja luonut koodin, joka tulostaa valmiiksi lasketun summan.
Seuraavassa on kolmas versio koodista, jossa koodille annetaan summan yläraja suorituksen aikana:
int main(void) {
    int n;
    scanf("%d", &n);
    long sum = 0;
    for (int i = 1; i <= n; i++) {
        sum += i;
    }
    printf("%ld\n", sum);
}
Nyt kääntäjä tuottaa koodin, joka laskee summan aidosti koodin suorituksen aikana, eikä se enää poista koodissa olevaa silmukkaa. Koodin suoritukseen kuluu aikaa noin 0.6 sekuntia, mikä on uskottava tulos.
Tässäkin tapauksessa koodia optimoiva kääntäjä voisi ainakin periaatteessa toteuttaa summan laskemisen tehokkaammin esimerkiksi käyttämällä summakaavaa n * (n + 1) / 2.
Tällainen muutos olisi kuitenkin varsin vaikea tehdä niin, että koodi toimisi varmasti samalla tavalla kaikissa tilanteissa. Esimerkiksi tässä pitäisi ottaa huomioon tilanne, jossa n on negatiivinen, jolloin summakaava ei anna samaa tulosta kuin alkuperäinen silmukka. Lisäksi pitäisi ottaa huomioon tilanne, jossa n on niin suuri, että summakaavassa tulee ylivuoto.
Koodin osien tehokkuus
Koodin optimoinnissa on usein hyödyllistä tietää, mitkä koodin osat vievät eniten aikaa koodia suorittaessa. Esimerkiksi jos tietyn koodin osan suoritukseen kuluu vain 1 % koodin kokonaissuoritusajasta, tämän osan optimointi ei vaikuttaisi lähes ollenkaan kokonaisuuteen.
Tarkastellaan esimerkkinä seuraavaa koodia, jolle annetaan lista kokonaislukuja ja joka ilmoittaa, montako eri lukua listassa on. Koodi laskee tuloksen järjestämällä aineiston ja vertailemalla vierekkäisiä lukuja järjestämisen jälkeen.
#include <stdio.h>
#include <stdlib.h>

void read_data(int *data, int n) {
    for (int i = 0; i < n; i++) {
        scanf("%d", &data[i]);
    }
}

int cmp(const void *a, const void *b) {
    int x = *(int*)a, y = *(int*)b;
    if (x < y) return -1;
    if (x == y) return 0;
    if (x > y) return 1;
}

int count_result(int *data, int n) {
    qsort(data, n, sizeof(int), cmp);
    int result = 1;
    for (int i = 1; i < n; i++) {
        if (data[i-1] != data[i]) result++;
    }
    return result;
}

int main(void) {
    int n;
    scanf("%d", &n);

    int *data = malloc(n * sizeof(int));
    read_data(data, n);

    int result = count_result(data, n);
    printf("result: %d\n", result);

    free(data);
}
Koodin suoritus 107 luvun aineistolla voisi näyttää seuraavalta:
$ time ./test < data.txt
result: 9950277

real	0m4.015s
user	0m3.947s
sys	0m0.067s
Voimme tarkastella koodin osien tehokkuutta muuttamalla pääfunktiota niin, että se laittaa muistiin ajanhetkiä koodin suorituksen aikana. Tämä onnistuu käytännössä käyttämällä standardikirjaston clock-funktiota. Funktio palauttaa aika-arvoja, joiden erotukset kertovat suoritusajan.
int main(void) {
    int n;
    scanf("%d", &n);
    int *data = malloc(n * sizeof(int));

    clock_t time1 = clock();
    read_data(data, n);
    clock_t time2 = clock();
    int result = count_result(data, n);
    clock_t time3 = clock();

    printf("result: %d\n", result);
    double duration1 = (double)(time2 - time1) / CLOCKS_PER_SEC;
    printf("read_data duration: %lf s\n", duration1);
    double duration2 = (double)(time3 - time2) / CLOCKS_PER_SEC;
    printf("count_result duration: %lf s\n", duration2);

    free(data);
}
Nyt koodin suoritus voisi näyttää seuraavalta:
$ ./test < data.txt
result: 9950277
read_data duration: 1.166300 s
count_result duration: 2.835903 s
Tämä kertoo, että funktion read_data suoritus vei aikaa noin 1.2 sekuntia ja funktion count_result suoritus vei aikaa noin 2.8 sekuntia.
Tarkempaa tietoa koodin osien tehokkuudesta voimme saada profiloimalla koodia. Tämä tarkoittaa, että koodi suoritetaan erityisellä tavalla niin, että saamme koodin suorituksen jälkeen raportin sen osien tehokkuudesta.
Linuxissa voimme käyttää esimerkiksi perf-työkalua seuraavasti:
$ perf record ./test < data.txt
$ perf report
Työkalun tuottama raportti voisi näyttää seuraavalta:
  37.18%  distinct  distinct           [.] cmp
  29.74%  distinct  libc.so.6          [.] msort_with_tmp.part.0
  16.93%  distinct  libc.so.6          [.] __vfscanf_internal
   6.57%  distinct  libc.so.6          [.] __GI_____strtoll_l_internal
   3.19%  distinct  libc.so.6          [.] __memmove_avx_unaligned_erms
   1.24%  distinct  libc.so.6          [.] __isoc99_scanf
   1.10%  distinct  libc.so.6          [.] _IO_sputbackc
   0.43%  distinct  libc.so.6          [.] __GI___libc_cleanup_pop_restore
   0.37%  distinct  distinct           [.] read_data
   0.36%  distinct  [kernel.kallsyms]  [k] _copy_to_iter
   0.35%  distinct  distinct           [.] count_result
   0.35%  distinct  libc.so.6          [.] __GI___libc_cleanup_push_defer
   0.24%  distinct  libc.so.6          [.] memcpy@@GLIBC_2.14@plt
   0.19%  distinct  libc.so.6          [.] __strtoll_internal
   0.13%  distinct  distinct           [.] __isoc99_scanf@plt
   0.10%  distinct  [kernel.kallsyms]  [k] rmqueue_bulk
Tämä raportti näyttää, että eniten aikaa vievät järjestämiseen liittyvät funktiot cmp sekä msort_with_tmp, joka on funktion qsort sisäisesti kutsuma funktio. Näiden jälkeen eniten aikaa vie funktio __vfscanf_internal, joka puolestaan on funktion scanf sisäisesti kutsuma funktio.
Työkalun perf käyttäminen voi vaatia, että järjestelmän suojausasetuksia lievennetään seuraavasti profilointia varten:
$ sudo sysctl -w kernel.perf_event_paranoid=1
$ sudo sysctl -w kernel.kptr_restrict=0
Nämä komennot muuttavat asetuksia väliaikaisesti niin, että asetukset palautuvat ennalleen, kun järjestelmä käynnistetään uudestaan.
Käännöksen optimointi
Koodin voi kääntää usealla eri tavalla konekielelle, ja kääntäjä pyrkii valitsemaan käännöksen, jonka prosessori suorittaa mahdollisimman nopeasti. Konekielinen käännös saattaa erota logiikaltaan paljonkin alkuperäisestä koodista, mutta tämä ei haittaa, kunhan koodin ulkoinen toiminta ei muutu.
Esimerkiksi komento x = 2 * x voidaan esittää x86-konekielellä seuraavilla tavoilla:
- Suora käännös käyttäen komentoa
mul, joka laskee kertolaskun:mov rbx, 2 mul rbx - Kertolaskua
2 * xvastaa yhteenlaskux + x, joten voimme käyttää myös komentoaaddseuraavasti:add rax, rax - Kertolaskun
2 * xvoi tehdä bittisiirrollax << 1, joten voimme käyttää myös komentoashlseuraavasti:shl rax, 1
Käännökset 2 ja 3 ovat käytännössä tehokkaampia kuin käännös 1, koska prosessorin on helpompaa suorittaa yhteenlasku tai bittisiirto kuin suorittaa kertolasku. Tämän takia kääntäjä valitsee todennäköisesti käännöksen 2 tai 3.
Rekisterien käyttäminen
Prosessorin rekisterit ovat nopeita muistipaikkoja, joiden käsittely on paljon nopeampaa kuin muistin käsittely. Kääntäjä pyrkii säilyttämään rekistereissä usein käytettäviä muuttujia. Tässä on haasteena, että prosessorin rekisterien määrä on rajoitettu eikä niissä voida säilyttää suurta määrää tietoa.
Modernit kääntäjät sisältävät edistyneitä algoritmeja, jotka määrittävät, mitä ohjelman muuttujia säilytetään rekistereissä missäkin ohjelman vaiheessa ja miten rekisterejä käytetään tehokkaasti.
C-kielen avainsana register antaa kääntäjälle vihjeen siitä, että tietty muuttuja on usein käytettävä ja se olisi hyvä laittaa rekisteriin. Esimerkiksi seuraavassa koodissa muuttujan i määrittelyssä on rekisterivihje:
register int i;
for (i = 0; i < n; i++) {
    sum += i;
}
Kuitenkin avainsanaa register käytetään nykyään harvoin, koska modernit kääntäjät tietävät yleensä ohjelmoijaa paremmin, miten rekistereitä kannattaa käyttää koodin käännöksessä. Todennäköisesti avainsanan register käyttämisellä ei ole mitään vaikutusta kääntäjän toimintaan.
Käytännössä C-koodissa oleva muuttuja päätyy usein rekisteriin ohjelman konekielisessä versiossa. Kuitenkaan näin ei tapahdu, jos koodissa viitataan muuttujan muistiosoitteeseen:
int n;
scanf("%d", &n);
Tässä muuttujalle n täytyy varata tilaa muistista, koska muuten sen muistiosoitetta ei voisi antaa funktiolle scanf. Toisaalta funktion kutsumisen jälkeen muuttujan sisältöä voisi säilyttää rekisterissä, jos muuttujan muistiosoitetta ei käytetä koodissa muulla tavalla.
Avainsanan register sivuvaikutuksena on, että koodissa ei voi olla viittausta muuttujan muistiosoitteeseen.
Silmukan purkaminen
Silmukan purkaminen (unrolling) on koodin optimointitekniikka, jossa silmukkaa muutetaan niin, että yksi uuden silmukan kierros vastaa useampaa alkuperäisen silmukan kierrosta. Tavoitteena on vähentää silmukan kierrosten määrää ja käyttää vähemmän konekielisiä komentoja silmukan hallinnointiin.
Tarkastellaan esimerkkinä seuraavaa silmukkaa, joka laskee summan taulukossa olevista luvuista:
for (int i = 0; i < n; i++) {
    sum += data[i];
}
Tavallinen tapa toteuttaa tällainen silmukka konekielellä on, että silmukan päätteeksi komento cmp vertaa silmukan laskuria loppuarvoon ja komento jne hyppää silmukan alkuun, jos silmukan tulee jatkua:
loop_start:
    ...
    cmp rcx, rdx
    jne loop_start
Tässä silmukassa komennot cmp ja jne suoritetaan n kertaa, koska silmukka muodostuu n kierroksesta.
Voisimme esittää samalla tavalla toimivan silmukan seuraavassa muodossa olettaen, että silmukan kierrosten määrä n on jaollinen kahdella:
for (int i = 0; i < n; i += 2) {
    sum += data[i];
    sum += data[i + 1];
}
Ideana on suorittaa silmukan sisällä kahta alkuperäisen silmukan kierrosta vastaavat komennot, jotta silmukan kierrosten määrä saadaan pienemmäksi. Tämän muutoksen jälkeen konekieliset komennot cmp ja jne suoritetaan vain n / 2 kertaa, eli näiden komentojen suoritusmäärä puolittuu.
Kääntäjät voivat purkaa silmukoita automaattisesti, jos ne arvioivat sen tehostavan koodia tai niitä ohjeistetaan erikseen siihen (esimerkiksi gcc:n parametri -funroll-loops). Silmukan purkamisen merkitys optimoinnissa on kuitenkin pienentynyt, eikä siitä ole välttämättä hyötyä uusissa prosessoreissa.
Silmukan purkaminen on esimerkki optimointitekniikasta, jossa koodin pituuden kasvattaminen voi tehostaa koodin suorittamista. Kun silmukan sisällä on useampi kopio alkuperäisen silmukan koodista, tämä kasvattaa käännetyn binääritiedoston kokoa.
Funktion upotus
Funktion kutsumista koodissa voidaan tehostaa funktion upotuksella (inlining) eli korvaamalla funktiokutsu koodilla, jonka funktio suorittaa sitä kutsuttaessa. Esimerkiksi koodi
int min(int a, int b) {
    if (a < b) return a;
    else return b;
}

void test(int a, int b) {
    int x = min(a, b);
}
voitaisiin muuttaa seuraavaan muotoon:
void test(int a, int b) {
    int x;
    if (a < b) x = a;
    else x = b;
}
Funktion upotus tehostaa koodin suoritusta, koska konekielisestä koodista jää pois funktion kutsumiseen liittyviä komentoja, jotka esimerkiksi välittävät funktiolle parametrit ja käsittelevät funktion paluuarvon.
Kääntäjät voivat upottaa funktion automaattisesti, jos ne arvioivat sen olevan hyödyllistä tehokkuuden kannalta. C99-standardi sisältää myös avainsanan inline, joka ohjeistaa kääntäjää upottamaan funktion.
Funktion upotus on siis melko samanlainen optimointitekniikka kuin silmukan purkaminen. Molemmat voivat tehostaa koodia vähentämällä suoritettavien komentojen (funktiokutsun toteutus tai silmukan hallinnointi) määrää. Toisaalta molemmat voivat kasvattaa suoritettavan binääritiedoston kokoa.
Komentojen tehokkuus
Vanhaan aikaan konekielisen koodin tehokkuuden arviointi oli melko suoraviivaista, koska prosessorit suorittivat komennot yksi kerrallaan ja jokaisesta komennosta tiedettiin, montako kellosykliä sen suorittaminen vie aikaa.
Esimerkiksi seuraavassa koodissa kommenteissa näkyy, montako kellosykliä kunkin komennon suorittaminen vie Intelin 80386-prosessorilla (vuodelta 1985):
    mov eax, 42              ; 2
    add eax, eax             ; 2
    shr eax, 1               ; 3
Koodin suoritus vie yhteensä 2 + 2 + 3 = 7 kellosykliä. Jos oletetaan prosessorin kellotaajuuden olevan 25 MHz, prosessori pystyy suorittamaan yllä olevan koodin 25 · 106 / 7 eli noin 3.57 miljoonaa kertaa sekunnissa.
Nykyään kuitenkaan konekielisen koodin suoritusaikaa ei voi laskea tällä tavalla, koska prosessorit ovat paljon monimutkaisempia ja suorittavat komentoja eri tilanteissa eri tavoilla. Tietystä konekielen komennosta ei ole enää mahdollista sanoa yleisesti, kauanko sen suorittaminen vie aikaa.
Rinnakkaisuus ja välimuistit
Moderneissa prosessoreissa on monenlaisia ominaisuuksia, jotka tehostavat koodin suoritusta ja toisaalta vaikeuttavat koodin tehokkuuden arviointia. Prosessorit suorittavat useita komentoja rinnakkain ja käyttävät välimuisteja, jotka nopeuttavat muistin käsittelyä.
Asiaa voi ajatella siltä kannalta, että prosessorit pyrkivät ennakoimaan koodin toimintaa yhtä komentoa pidemmälle ja suorittamaan koodin kokonaisuutena tehokkaasti. Jos koodissa on peräkkäin komentoja, jotka eivät vaikuta toisiinsa, prosessori voi suorittaa ne yhtä aikaa. Jos koodi lukee muistia tietystä kohdasta, välimuistiin voidaan hakea valmiiksi seuraavana muistissa olevan kohdan sisältö siltä varalta, että koodi lukee myöhemmin senkin.
Rinnakkaiset komennot
Prosessori pystyy suorittamaan peräkkäisiä komentoja erityisen tehokkaasti, jos komennot voidaan suorittaa toisistaan riippumatta. Tämä tarkoittaa esimerkiksi, että komennot eivät muuta samaa kohtaa muistista eikä ole merkitystä, missä järjestyksessä komennot suoritetaan toisiinsa nähden.
Tarkastellaan esimerkkinä seuraavaa koodia, joka laskee luvun N kertoman. Koska kertoma voi olla suuri luku, koodi laskee tuloksen modulo M.
long result = 1;
for (int i = 1; i <= N; i++) {
    result *= i;
    result %= M;
}
printf("%ld\n", result);
Kun N on 109, koodin suoritus vie aikaa testikoneella 8.3 sekuntia.
Voimme yrittää tehostaa koodia purkamalla silmukkaa niin, että samalla kierroksella suoritetaan useita laskutoimituksia. Esimerkiksi:
long result = 1;
for (int i = 1; i <= N; i += 2) {
    result *= i;
    result %= M;
    result *= (i + 1);
    result %= M;
}
printf("%ld\n", result);
Tämä ei kuitenkaan vielä vaikuta tehostavan koodia, vaan suoritus vie edelleen saman verran aikaa. Silmukan purkaminen ei ehkä auta tässä tapauksessa, koska prosessori pystyy ennustamaan silmukan jatkumisen ja toteuttaa sen hyvin nopeasti.
Voimme kuitenkin tehostaa koodia merkittävästi muuttamalla sitä niin, että prosessori pystyy suorittamaan komentoja rinnakkain. Esimerkiksi seuraavasti:
long result0 = 1;
long result1 = 1;
for (int i = 1; i <= N; i += 2) {
    result0 *= i;
    result0 %= M;
    result1 *= (i + 1);
    result1 %= M;
}
long total = result0 * result1 % M;
printf("%ld\n", total);
Tämä koodi laskee kertoman kahden muuttujan avulla: result0 sisältää parittomat luvut (1 · 3 · 5 · …) ja result1 sisältää parilliset luvut (2 · 4 · 6 · …). Silmukan jälkeen koodi laskee lopullisen tuloksen kertomalla nämä muuttujat toisillaan.
Tämän muutoksen jälkeen koodin suoritus vie aikaa vain 4.2 sekuntia eli suoritusaika lähes puolittuu. Koska koodissa on erilliset muuttujat result0 ja result1, koodi pystyy suorittamaan rinnakkain näihin muuttujiin liittyviä komentoja. Esimerkiksi komennot result0 *= i ja result1 *= (i + 1) voidaan suorittaa rinnakkain, koska ne vaikuttavat eri muuttujien sisältöön.
Voimme yleistää tämän idean niin, että laskenta jaetaan P osaan, joita voidaan käsitellä toisistaan riippumattomasti:
long result[P];
for (int p = 0; p < P; p++) {
    result[p] = 1;
}
for (int i = 1; i <= N; i += P) {
    for (int p = 0; p < P; p++) {
        result[p] = result[p] * (i + p) % M;
    }
}
long total = 1;
for (int p = 0; p < P; p++) {
    total = total * result[p] % M;
}
printf("%ld\n", total);
Seuraava taulukko näyttää koodin suoritusajat P:n eri arvoilla:
Parametri P |
Suoritusaika |
|---|---|
| 1 | 8.3 s |
| 2 | 4.2 s |
| 4 | 3.0 s |
| 8 | 2.4 s |
| 16 | 1.8 s |
| 32 | 2.1 s |
Tässä tapauksessa koodi toimii nopeiten P:n arvolla 16, jolloin suoritusaika on vain 1.8 sekuntia eli alle neljännes alkuperäisen koodin suoritusajasta.
Välimuistin toiminta
Välimuisti (cache) on tehokas muistialue, joka sisältää osan tietokoneen muistista nopeampaa käsittelyä varten. Kun koodi käsittelee tiettyä muistin kohtaa, muistin sisältö tämän kohdan lähellä voidaan siirtää välimuistiin. Tämä tehostaa koodia, jos koodi käsittelee myöhemmin muistia saman kohdan läheltä.
Moderneissa prosessoreissa on yleensä useita välimuisteja. Esimerkiksi Intelin prosessoreissa on tyypillisesti kolme välimuistia:
- L1 on nopein välimuisti (koko esimerkiksi 32 kilotavua)
- L2 on keskinopea välimuisti (koko esimerkiksi 2 megatavua)
- L3 on hitain välimuisti (koko esimerkiksi 12 megatavua)
Kun koodi käsittelee tiettyä muistin kohtaa, se käy ensin läpi välimuistit pienimmästä suurimpaan ja tarkastaa, sisältyykö käsiteltävä kohta johonkin välimuisteista. Jos sisältyy, koodi käsittelee muistia välimuistin kautta, mikä on paljon nopeampaa kuin muistin käsittely suoraan.
Välimuisti tehostaa koodin suoritusta esimerkiksi koodin käydessä läpi taulukon sisältöä. Koska taulukon alkiot on tallennettu peräkkäin muistissa, taulukkoa käsittelevä koodi voi hyötyä paljon välimuistista. Toisaalta koodi kannattaa pyrkiä suunnittelemaan niin, että se käsittelee peräkkäisiä muistin kohtia.
Tarkastellaan esimerkkinä välimuistin vaikutusta koodissa, joka käy läpi T kertaa kaksiulotteisen N x N -kokoisen taulukon sisällön:
long sum = 0;
for (int k = 0; k < T; k++) {
    for (int i = 0; i < N; i++) {
        for (int j = 0; j < N; j++) {
            sum += grid[i][j];
        }
    }
}
printf("%ld\n", sum);
Testataan koodia parametreilla T = 500 ja N = 3000 seuraavin muunnoksin:
- Viittaustapa:
[i][j](läpikäynti rivi kerrallaan vasemmalta oikealle) tai[j][i](läpikäynti sarake kerrallaan ylhäältä alas) - Taulukon alkion tyyppi:
char(1 tavu),int(4 tavua) tailong(8 tavua)
Seuraava taulukko näyttää koodin suoritusajat testikoneella eri tilanteissa:
| Viittaustapa | Alkiotyyppi | Suoritusaika |
|---|---|---|
[i][j] |
char |
2.7 s |
[i][j] |
int |
1.9 s |
[i][j] |
long |
3.3 s |
[j][i] |
char |
6.9 s |
[j][i] |
int |
33.6 s |
[j][i] |
long |
21.4 s |
Taulukosta näkee, että viittaustapa [i][j] (rivi kerrallaan) on selvästi nopeampi kuin viittaustapa [j][i] (sarake kerrallaan). Tämä johtuu siitä, että kaksiulotteisen taulukon sisältö on muistissa rivi kerrallaan ja koodi hyödyntää välimuistia paremmin, kun se myös käy taulukon läpi rivi kerrallaan.
Taulukon sisältö muistissa näyttää seuraavalta:
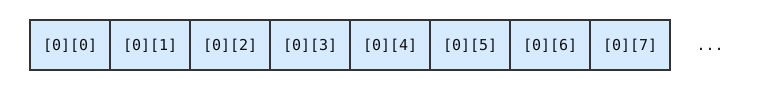
Kun koodi käyttää viittaustapaa [i][j], se käy läpi tämän muistialueen sisällön alkio kerrallaan vasemmalta oikealle, mikä on välimuistin kannalta ihanteellinen tapa käsitellä muistia. Viittaustavassa [j][i] koodi puolestaan tekee muistissa N alkion pituisia hyppyjä, mikä sopii huonosti yhteen välimuistin kanssa.
Viittaustavassa [j][i] taulukon alkion tyyppi vaikuttaa myös paljon koodin nopeuteen. Koodi toimii selvästi nopeiten alkion tyypin ollessa char, jolloin taulukko vie vähän tilaa muistissa ja koodi luultavasti pystyy käyttämään melko hyvin välimuistia huonosta viittaustavasta huolimatta. Tässä char-tyyppisen taulukon koko on 9 megatavua, mikä saattaa esimerkiksi mahtua kokonaan L3-välimuistiin.
Toisaalta viittaustavassa [j][i] koodi toimii yllättäen nopeammin alkiotyypillä long kuin int. Tämä ero ei välttämättä liity välimuistiin, vaan se voi liittyä myös johonkin muuhun asiaan muistin käsittelyssä. Jostain syystä koodi pystyy tässä tilanteessa viittaamaan tehokkaammin long-taulukkoon kuin int-taulukkoon.
Liukuvan ikkunan minimi (osa 2)
Toteutimme luvussa 5 koodin, joka laskee liukuvan ikkunan minimin tehokkaasti deque-rakenteen avulla. Koodin suoritus vie aikaa 2.1 sekuntia suurella aineistolla, mikä on sinänsä hyvä tulos, mutta voisimmeko tehostaa koodia lisää?
Koodin toteutus luvusta 5:
#include <stdio.h>
#include <stdlib.h>

int main(void) {
    int n, m;
    scanf("%d %d", &n, &m);

    int *data = malloc(sizeof(int) * n);
    for (int i = 0; i < n; i++) {
        scanf("%d", &data[i]);
    }

    int *deque = malloc(sizeof(int) * n);
    int *minima = malloc(sizeof(int) * (n - m + 1));
    int left = 0, right = -1;
    for (int i = 0; i < n; i++) {
        if (i - deque[left] == m) left++;
        while (left <= right && data[deque[right]] >= data[i]) {
            right--;
        }
        deque[++right] = i;
        if (i >= m - 1) {
            minima[i - (m - 1)] = data[deque[left]];
        }
    }

    for (int i = 0; i < n - m + 1; i++) {
        printf("%d\n", minima[i]);
    }

    free(data);
    free(deque);
    free(minima);
}
Käytetty testiaineisto:
- Lukujen määrä n on 107
- Jokainen luku on satunnainen kokonaisluku välillä 1…109
- Ikkunan koko m on 106
Seuraavassa on perf-työkalun raportti, joka antaa tässä tapauksessa hyvin hyödyllistä tietoa koodin optimointia varten:
  32.52%  window_final1  libc.so.6          [.] __vfscanf_internal
  13.37%  window_final1  libc.so.6          [.] __GI_____strtoll_l_internal
  11.08%  window_final1  libc.so.6          [.] __printf_buffer
  10.83%  window_final1  window_final1      [.] main
   5.53%  window_final1  libc.so.6          [.] __printf_buffer_write
   2.85%  window_final1  libc.so.6          [.] __vfprintf_internal
   2.31%  window_final1  libc.so.6          [.] _itoa_word
   2.25%  window_final1  libc.so.6          [.] __printf_chk
   2.15%  window_final1  libc.so.6          [.] __memmove_avx_unaligned_erms
   2.02%  window_final1  libc.so.6          [.] __isoc99_scanf
   1.71%  window_final1  libc.so.6          [.] _IO_sputbackc
   1.37%  window_final1  libc.so.6          [.] __strchrnul_avx2
   1.13%  window_final1  libc.so.6          [.] __printf_buffer_to_file_done
   0.92%  window_final1  libc.so.6          [.] __printf_buffer_to_file_switch
   0.84%  window_final1  libc.so.6          [.] __GI___libc_cleanup_push_defer
   0.68%  window_final1  libc.so.6          [.] memcpy@@GLIBC_2.14@plt
   0.67%  window_final1  libc.so.6          [.] __GI___libc_cleanup_pop_restore
   0.66%  window_final1  [kernel.kallsyms]  [k] _copy_to_iter
   0.56%  window_final1  libc.so.6          [.] __printf_buffer_to_file_init
   0.56%  window_final1  libc.so.6          [.] __printf_buffer_done
Raportti näyttää, että merkittävä osa koodin suoritusajasta kuluu syötteen lukemiseen ja tulostamiseen. Erityisesti melkein kolmanneksen suoritusajasta vie funktio __vfscanf_internal, joka on nimestä päätellen funktion scanf sisäisesti kutsuma apufunktio.
Syötteen lukemisen optimointi
Vaikuttaa siis siltä, että koodin pullonkaulana on seuraava silmukka:
    for (int i = 0; i < n; i++) {
        scanf("%d", &data[i]);
    }
Testiaineistolla koodi kutsuu 107 kertaa scanf-funktiota, ja jokainen funktiokutsu lukee yhden kokonaisluvun syötteestä. Voimme tehostaa koodia luopumalla scanf-funktiosta ja lukemalla syöte itse matalammalla tasolla:
#define BUFFER_SIZE 1024
    char buffer[BUFFER_SIZE];
    int read_pos = 0;
    int read_value = 0;
    int read_start = 0;
    int read_count;
    while (read_count = fread(buffer, 1, BUFFER_SIZE, stdin)) {
        for (int i = 0; i < read_count; i++) {
            if (buffer[i] >= '0' && buffer[i] <= '9') {
                read_value = read_value * 10 + buffer[i] - '0';
                read_start = 1;
            } else if (read_start) {
                data[read_pos] = read_value;
                read_pos++;
                read_value = 0;
                read_start = 0;
            }
        }
    }
Koodi lukee syötettä tavutasolla funktiolla fread puskuriin buffer. Koodi käy luetun syötteen läpi tavu kerrallaan ja muodostaa muuttujaan read_value kunkin syötteessä olevan luvun. Kun syötteessä on numero 0…9, koodi lisää sen luvun read_value loppuun. Muuten koodi tulkitsee luvun olevan valmis ja lisää sen taulukkoon data.
Tämän optimoinnin jälkeen koodin suoritusaika on 1.2 sekuntia, eli optimointi on varsin onnistunut ja melkein puolitti koodin suoritusajan.
Syötteen luku itse toteutettuna on tehokas, mutta se on myös selvästi alkeellisempi kuin scanf-funktion toteutus. Koodissa ei ole virheenkäsittelyä ja se olettaa lisäksi, ettei luku ole negatiivinen eli siinä ei ole --merkkiä alussa.
Tulostuksen optimointi
Voimme vastaavasti optimoida myös koodin tulostussilmukkaa:
    for (int i = 0; i < n - m + 1; i++) {
        printf("%d\n", minima[i]);
    }
Seuraava koodi toteuttaa matalan tason tulostamisen printf-funktion sijasta:
#define BUFFER_SIZE 1024
    char buffer[BUFFER_SIZE];
    int buffer_pos = 0;
    for (int i = 0; i < n - m + 1; i++) {
        int value = minima[i];
        int start = 0;
        for (int div = 1000000000; div >= 1; div /= 10) {
            if (start || value / div > 0 || div == 1) {
                buffer[buffer_pos++] = value / div + '0';
                value -= value / div * div;
                start = 1;
            }
        }
        buffer[buffer_pos++] = '\n';
        if (buffer_pos > BUFFER_SIZE - 20 || i == n - m) {
            fwrite(buffer, 1, buffer_pos, stdout);
            buffer_pos = 0;
        }
    }
Koodi muodostaa tulostettavat luvut puskuriin buffer ja käyttää sitten funktiota fwrite lukujen tulostamiseen. Koodi muodostaa puskuriin peräkkäin useamman tulostettavan luvun ja kutsuu funktiota fwrite puskurin tullessa täyteen.
Koodi muodostaa kokonaisluvun numeroesityksen jakamalla lukua 10:n potensseilla suurimmasta pienimpään (109, 108, 107, jne.), jolloin jokainen jakolaskun tulos antaa yhden luvun numeron.
Tämän optimoinnin jälkeen koodin suoritusaika on 0.8 sekuntia, eli onnistuimme saamaan suoritusajan sekunnin rajan alapuolelle.
Kuten syötteen luvussa, tässäkin koodissa on erilaisia oletuksia, jotka tehostavat sen toimintaa. Koodi olettaa, että tulostettava luku on välillä 1…109 eli jakamisen voi aloittaa luvusta 109 eikä luku ole negatiivinen.
Mitä seuraavaksi?
Yksi trikki on vielä käyttämättä: olemme kääntäneet koodin optimointilipulla -O2, mutta aina voi kokeilla saada lisäoptimointeja lipulla -O3. Tässä tapauksessa tämä tehostaa koodia vielä niin, että suoritusajaksi tulee 0.5 sekuntia.
Voisiko koodia tehostaa vielä lisää? Ainakin seuraavia asioita voisi vielä kokeilla:
- Syötteen ja tulosteen käsittelyn tehostaminen
- Algoritmin logiikan tehostaminen
- Muistinkäytön vähentäminen: koodi varaa tällä hetkellä melko paljon muistia, mikä voi hidastaa koodin suoritusta
- Rinnakkaistaminen: koodia voisi olla mahdollista tehostaa käsittelemällä useita liukuvia ikkunoita rinnakkain